Память ИИ-агента: как сделать, чтобы он помнил клиента и прошлые обращения
Четыре вида памяти ИИ-агента и где их хранить: инструменты, векторная база, вики со ссылками, SQL и скиллы. Как агент помнит клиента и что ему не запоминать.
Сама модель между разговорами ничего не помнит. Память ИИ-агента — это хранилища вокруг модели: из них агент перед ответом берёт нужное, а после ответа записывает новое. Обычно выделяют четыре вида памяти: текущий разговор, знания, прошлый опыт и правила работы. Для каждого вида свой способ хранения.
Мы используем шесть источников памяти: инструменты, которые ходят в системы компании, векторную базу документов, заметки со ссылками друг на друга, обычную базу с SQL-запросами, инструкции и кэш. В каждом проекте набор свой, и каждую часть настраивают под задачу и данные компании.
Четыре вида памяти на примере агента поддержки
Представим агента, который отвечает клиентам. Ему нужно держать в голове текущий диалог, знать правила компании, помнить прошлые обращения этого клиента и понимать, как оформить возврат.
С текущим диалогом всё проще всего: модель его не хранит, поэтому с каждым новым сообщением мы отправляем ей всю переписку этого чата целиком, вместе с результатами запросов к системам. Остальные три вида памяти так не передашь, они лежат в отдельных хранилищах.
| Вид памяти | Что хранит | Пример у агента поддержки | Где обычно лежит |
|---|---|---|---|
| Рабочая | текущий диалог, результаты запросов к системам | клиент только что назвал номер заказа | история текущего чата, которую отправляем модели с каждым запросом |
| Знания | факты, документы, регламенты | условия доставки и гарантии | векторная база, корпоративная вики |
| Опыт | прошлые события и действия агента | в прошлом месяце клиенту уже меняли товар | CRM, обычная база |
| Навыки | правила, как выполнять задачу | порядок оформления возврата | инструкция агента, скиллы, таблица в базе |
В документации LangChain, одного из популярных инструментов для сборки агентов, процедурную память описывают как сочетание весов модели, кода агента и его инструкции. На практике агенты редко меняют веса и код, чаще дорабатывают свою инструкцию. Поэтому «навыки» агента — это прежде всего текст: инструкции и правила, которые можно читать и править.
Тип памяти не привязан к технологии. Опыт можно хранить в обычной базе и дополнительно сделать по нему векторный поиск, чтобы находить похожие обращения. Как собрать такую память под свою задачу, видно по ИИ-агентам для бизнеса, которые мы делаем.
Где хранить память: шесть способов, которые мы сочетаем
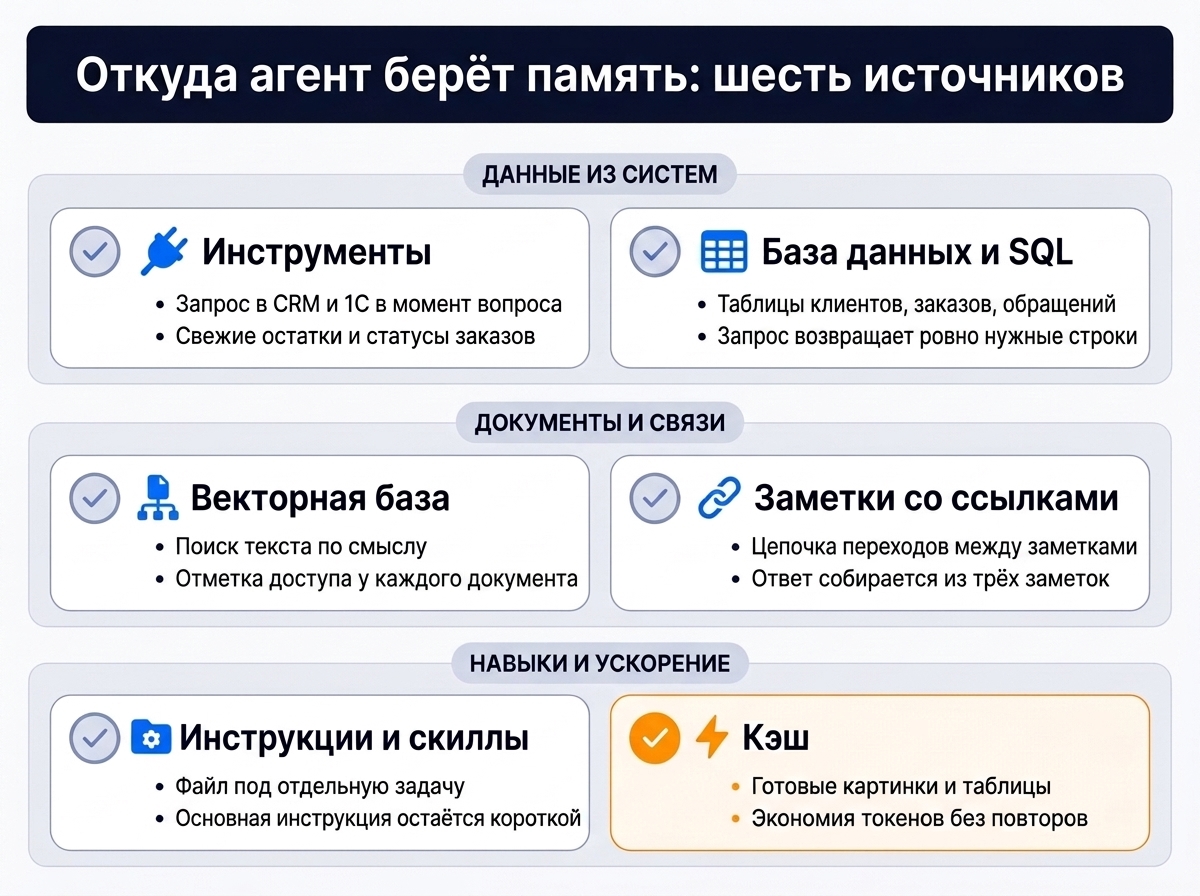
Шесть источников памяти ИИ-агента: инструменты, SQL, векторная база, заметки со ссылками, скиллы и кэш
Инструменты: агент спрашивает систему сам
Часть памяти агенту не нужно хранить у себя. Остатки, статусы заказов и цифры продаж меняются каждый час, поэтому агент берёт их из CRM, 1С или Метрики в момент вопроса через инструменты. Так он не путает вчерашний остаток с сегодняшним. Как подключать агента к CRM, базам данных и API, мы разбирали отдельно.
Так устроена система анализа продаж и звонков, которую мы разработали: Метрика, коллтрекинг Calltouch, CRM и Git сведены в одну систему, и ИИ находит связи между изменениями в коде и маркетинговыми метриками.
Векторная база: поиск по смыслу
Документы режут на куски, каждый кусок превращают в числовой вектор, который передаёт его смысл, и складывают в векторную базу. Вопрос пользователя тоже превращают в вектор, и база находит ближайшие по смыслу куски. Этот механизм лежит в основе RAG-систем.
Когда мы делали чат-бота техподдержки для автодилера, в базу ушли больше 200 инструкций по ERP, CRM и 1С. Текст резали на куски по 1500 символов с перекрытием 300, а искали сразу по смыслу и по точным словам. У каждого документа своя отметка доступа: документы, закрытые для пользователя, бот в этом чате просто не видит. Как подготовить сами документы, мы описали в статье про корпоративную базу знаний.
Заметки со ссылками: агент идёт по цепочке
Векторный поиск находит похожие куски, но теряет связи между документами. Заметки в корпоративной вики эти связи сохраняют. Например, сотрудник спрашивает, как согласовать договор. Агент открывает регламент, видит в нём ссылку на шаблон договора, переходит по ней, оттуда по ссылке попадает в список исключений для крупных сделок. Ответ собирается из трёх заметок, связанных самой компанией.
Это граф: заметки — узлы, ссылки — связи. Только строить его не нужно отдельно: сотрудники и так ставят ссылки, когда пишут регламенты.
Обычная база и SQL: точные данные
Где нужен точный ответ, а не похожий, мы храним данные в таблицах: клиенты, заказы, обращения, маршруты согласования. Агент через инструмент отправляет запрос, например «все заказы клиента за полгода», и получает ровно эти строки.
В ИИ для онбординга маршруты согласования документов, бюджетов и оплат мы положили в реляционную базу, информацию о документах — в векторную, и подключили 1С. Менеджер пишет в мессенджер и получает ответ, какие документы нужны и через кого они проходят.
Инструкции и скиллы: как делать задачу
Навыки агента живут в инструкции и в скиллах. Скилл — это отдельный файл с инструкцией под одну задачу: агент открывает его, только когда берётся за эту задачу. Так основная инструкция остаётся короткой, а правила под каждую задачу лежат отдельно. Скиллы подключаются в оболочках для агентов, их называют харнесами.
Кэш: не делать одну работу дважды
Картинки и таблицы, которые агент уже разобрал или собрал, мы кладём в кэш. Когда они снова понадобятся, агент берёт готовый результат и не обрабатывает их заново. Ответ приходит быстрее, а модель не тратит токены на ту же работу ещё раз.