Как спрятать персональные данные от ИИ: настройка Presidio и Natasha для русского языка
Presidio и Natasha из коробки пропускают русские паспорта, ИНН и адреса. Что настроить в четыре шага и как совместить защиту со скоростью чат-бота.
Поставить библиотеку для маскирования персональных данных мало: из коробки она плохо работает с русским. Presidio и Natasha находят имена, но пропускают паспорта, ИНН, СНИЛС и адреса. Рабочая защита собирается из четырёх шагов, и последний из них, проверку небольшой моделью, ставят только там, где можно подождать.
С какими проблемами сталкиваешься при первой настройке
Первая настройка обычно идёт на русских репликах из чата: имя, телефон, паспорт, ИНН, адрес. И сразу видно, что библиотеки с коробки закрывают только часть задачи.
Presidio находит часть имён и телефонов, а паспорта, ИНН, СНИЛС и номер карты в основном пропускает. Встроенные правила для документов у него американские: номер социального страхования и паспорт США. Для ИНН, СНИЛС и российского паспорта их нет. Natasha, наоборот, неплохо находит имена и города, но цифры документов не видит совсем, потому что она для этого не предназначена. Адрес целиком, с домом и квартирой, не находит ни одна из них.
Вывод: одна библиотека задачу не закрывает. Нужна цепочка, где каждый шаг ловит своё.
Четыре шага, которые закрывают разные дыры
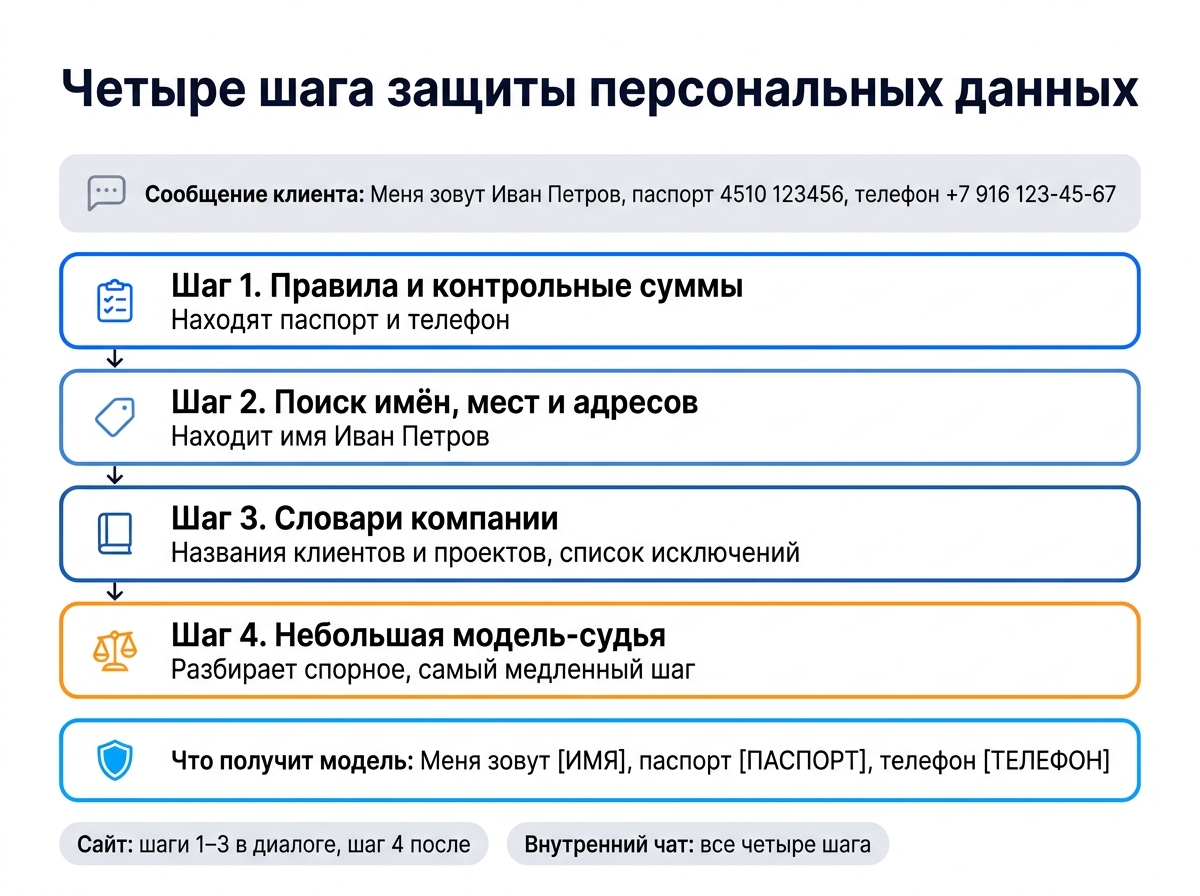
Четыре шага защиты персональных данных на примере одного сообщения клиента
Первый шаг: правила и контрольные суммы
Документы с жёсткой структурой лучше всего ловят обычные правила. У ИНН десять знаков у организаций и двенадцать у физических лиц, последние цифры контрольные. У СНИЛС есть контрольное число, у банковских карт проверка по алгоритму Луна. Так отсеиваются случайные цифры, и защита не прячет номер заказа вместо ИНН. У паспорта контрольной суммы нет: серия из четырёх цифр и номер из шести выглядят как любое число, поэтому его ищут по слову рядом, например «паспорт» или «серия». Телефоны и почта тоже ловятся правилами. Шаг быстрый, точное время мы замеряем на сервере клиента.
Второй шаг: поиск имён, мест и адресов
Здесь нужна языковая модель русского. Natasha и русская модель spaCy (она подключается к Presidio напрямую) находят фамилии, имена, города и организации. Natasha обучали на новостных текстах, и на других текстах качество может быть ниже. Живой чат с опечатками и именами строчными буквами к ним относится. Для адресов нужен отдельный разбор: в Natasha есть встроенный экстрактор адресов, но адрес с домом и квартирой целиком она находит не всегда. Улицы и дома лучше сверять со справочником. Шаг быстрый, обычно это миллисекунды на сообщение, точное время мы замеряем на сервере клиента.
Третий шаг: словари компании
Библиотеки не знают, что для вас секрет. Названия клиентов, проектов, номера договоров, внутренние коды добавляют списком. Здесь же держат и список исключений. На первой настройке Presidio легко принимает «Битрикс24» или «Telegram» за имена и прячет их, хотя это названия программ. Исключения собирают из реальных диалогов за первые недели работы.
Четвёртый шаг: небольшая модель как судья
После первых трёх шагов остаются спорные случаи: «живу за Невским, дом с аркой, квартира семь» или фамилия в середине предложения без слов «клиент» и «ФИО» рядом. Их разбирает небольшая локальная модель вроде Qwen: ей показывают текст и спрашивают, что ещё похоже на персональные данные. Это самый гибкий шаг: он разбирает то, что правила не ловят. Он же самый медленный и добавляет задержку, которую нужно мерить на своём железе. Поэтому его ставят не везде.
Чтобы выбрать настройки, нужен свой набор проверочных реплик: пара сотен настоящих сообщений, в которых данные заранее отмечены. На нём считают две вещи: сколько данных пропущено и сколько лишнего спрятано. Пропуск опаснее, лишнее прятать дороже обходится в качестве ответов, и баланс каждая компания выбирает сама.