Fine-tuning: как дообучить модель под свою задачу
Что такое fine-tuning, для каких задач дообучают модели, чем LoRA отличается от QLoRA, какие нужны видеокарта и программы и как мы дообучали свою модель
Fine-tuning, или дообучение модели, — это обучение готовой нейросети на примерах вашей задачи. Модель уже знает язык. Дообучение учит её одному конкретному делу: отвечать в нужном формате, относить обращения к нужной теме, находить в тексте нужные данные. Часто так дообучают небольшие открытые модели, которые потом работают на своём сервере: быстро, без облака, данные не уходят наружу.
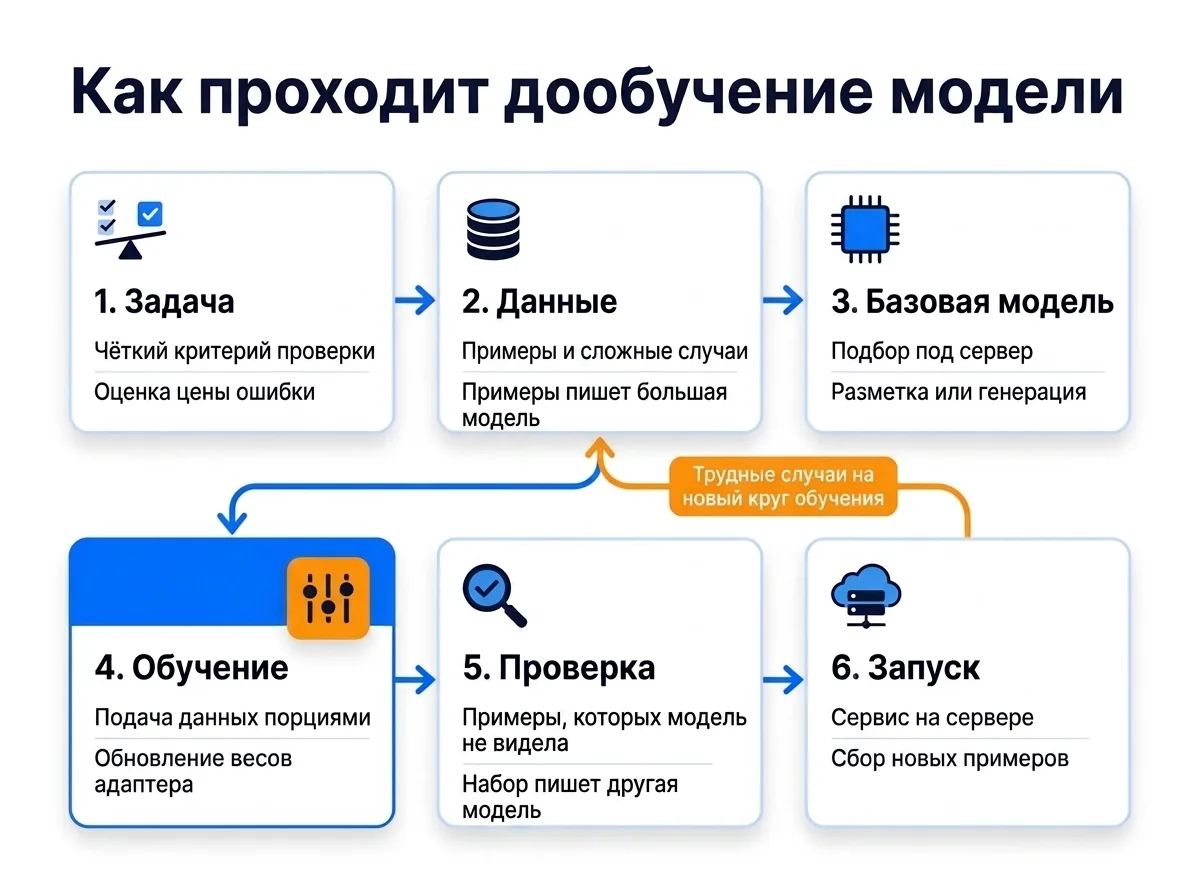
Для дообучения нужны три вещи: набор примеров с правильными ответами, базовая модель и видеокарта на время обучения. Ниже разбираем, для каких задач это подходит, какие есть способы и как проходит работа.
Чем fine-tuning отличается от промпта и RAG
Настроить модель под задачу можно тремя способами, и они меняют разное.
| Способ | Что меняется | Когда подходит |
|---|---|---|
| Промпт | инструкция, которую модель получает с каждым запросом | задачу можно объяснить словами |
| RAG | документы, которые модель получает вместе с вопросом | модели нужны ваши данные: договоры, регламенты, база знаний |
| Fine-tuning | сама модель | задачу проще показать на примерах, чем описать |
Обычно начинают с промпта: это дешевле и быстрее. Если модели нужны факты из документов компании, подключают RAG. Дообучение берут, когда инструкция уже не помогает: модель ошибается на похожих случаях, путает формат или работает слишком медленно. Как мы подходим к таким задачам, описано на странице про дообучение моделей под задачу.
Для каких задач нужно дообучение
Классификация. Модель выбирает ответ из готовых вариантов: к какому отделу относится обращение, есть ли в письме жалоба, срочная ли заявка. Для таких задач хватает самой маленькой модели.
Поиск данных в тексте. Модель находит в тексте имена, адреса, номера документов или нужные поля договора. Правила и готовые библиотеки хорошо ловят аккуратно написанные данные. С живой перепиской они справляются хуже.
У нас была такая задача: находить имена и другие персональные данные в сообщениях до отправки во внешнюю нейросеть. Аккуратно написанные данные ловят правила и библиотеки. Имена строчными буквами и данные в живой переписке ищет дообученная модель. Остальные шаги защиты описаны в статье про то, как спрятать персональные данные от ИИ.
Стабильный формат ответа. Модель отвечает строго в заданной форме, например JSON с нужными полями, и не добавляет лишнего текста. Это важно, когда ответ модели читает программа.
Перенос умения большой модели в маленькую. Этот приём называют дистилляцией. Большая модель решает задачу хорошо, но дорого и медленно. Её ответами дообучают маленькую, и та решает ту же задачу на своём сервере.
Новым фактам дообучение не учит: свежим ценам, содержанию договоров, изменениям в регламентах. Факты устаревают, и переобучать модель после каждого изменения долго. Для этого используют RAG.
Полное дообучение, LoRA и QLoRA
Дообучить модель можно целиком или частично.
Полное дообучение меняет все веса модели, то есть числа, в которых хранятся её знания. Это самый дорогой способ: большой модели обычно нужно несколько мощных видеокарт, а результат весит столько же, сколько исходная модель.
LoRA оставляет модель как есть и обучает небольшие дополнительные слои поверх неё. Авторы метода из Microsoft показали: на модели GPT-3 он сокращает число обучаемых параметров в 10 000 раз, а нужную память видеокарты в три раза. Обученные слои хранятся отдельным небольшим файлом, его называют адаптером. К одной базовой модели можно подключать разные адаптеры под разные задачи.
QLoRA делает то же самое, но базовую модель сначала сжимает до 4 бит. Так большая модель помещается в память одной видеокарты: авторы метода дообучили модель на 65 миллиардов параметров на одной видеокарте с 48 ГБ памяти.
Мы дообучаем через LoRA. Для небольших моделей это самый простой путь: обучение идёт быстро, а адаптер легко заменить новой версией.