Как тестировать голосовых агентов на акценты, шум и перебивания перед запуском?
Практическая схема тестирования голосовых агентов: профиль трафика, сценарии с шумами и перебиваниями, гибрид живых и синтетических записей, метрики и регрессия
Тестируйте голосового агента на трёх видах помех: акцентах, шуме и перебиваниях. Оценивайте результат задачи (бронь создана, возврат оформлен, адрес записан верно), а не красоту расшифровки разговора. Ниже схема проверок, которую стоит пройти до запуска, а не на клиентах.
Голосовой агент часто блестяще ведёт демо в тишине, а в реальных звонках с акцентами, шумом и перебиваниями превращается в «глухого робота». Дело обычно не в «уме» языковой модели, а в звуке: акцент собеседника, плохая связь, перебивание агента клиентом и речь двух людей одновременно.
1. Почему пары пробных звонков недостаточно
Голосовой агент ломается на условиях разговора:
- акцент и скорость речи собеседника;
- канал связи: обычная телефонная сеть, мобильная сеть, Bluetooth, громкая связь;
- фон: машина, офис, дети, телевизор;
- перебивания, параллельная речь, вставки «угу» и «ага».
Поэтому проверяйте агента по условиям (акцент, шум, канал, перебивания) и по сценариям. Смотрите на результат задачи: бронь создана, возврат оформлен, адрес записан без ошибок, а при непонимании агент передаёт разговор человеку.
2. Пять слоёв проверки
Разложите систему на пять слоёв и тестируйте каждый отдельно.
- Входной звук. Акценты и диалекты, скорость речи, запинки и самопоправки, устройство и канал связи.
- Шум и искажения. Фон (машина, улица, офис, кафе, дети, музыка, телевизор), искажения звука (эхо помещения, перегруз сигнала, сжатие кодеками, скачки задержки и потеря пакетов в сети), чужая речь рядом.
- Перебивания и очерёдность реплик. Осмысленное перебивание («подождите, не на сегодня»), ложное перебивание из-за шума или вставок вроде «угу» и смеха, удержание контекста, когда говорят двое.
- Смысл и действия. Намерение клиента и данные в нём (даты, суммы, имена, адреса), исправления («не на пятницу, а на четверг»), передача человеку и безопасное завершение при непонимании.
- Качество разговора. Задержки, естественность пауз, не «зависает» ли агент, переспрашивание при ошибках распознавания речи, отсутствие выдуманных фактов под шумом и с трудным акцентом.
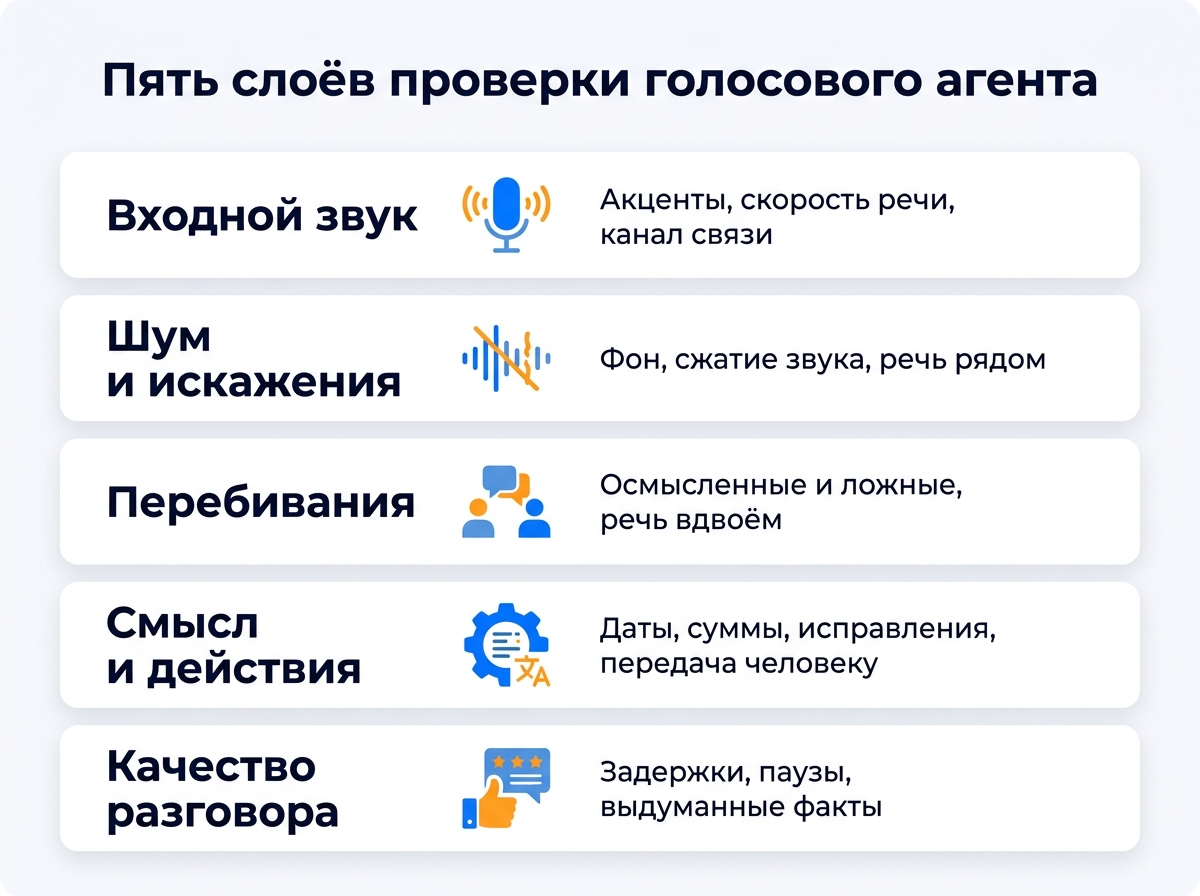
Схема из пяти слоёв проверки голосового агента: звук, шум, перебивания, смысл, качество разговора
3. Как построить проверку
Шаг 1. Определите профиль звонков
Прежде чем писать тест-кейсы, поймите, кого и где вы будете слушать:
- регионы и акцентные группы (региональные говоры, люди, для которых русский не родной);
- доля звонков с мобильных, городских номеров и интернет-телефонии;
- типичный шум: склад и дорога у логистики, офис у финансовых компаний, дом и улица у розничных клиентов.
Возьмите 3–5 основных акцентных групп и 3–4 шумовых профиля и стройте тестовую матрицу по ним.
Шаг 2. Соберите набор сценариев
Нужен полноценный набор, а не горсть фраз. Мы советуем ориентироваться на 20–50 сценариев:
- 5–10 идеальных, без сбоев;
- 10–20 «грязных»: с исправлениями, сменой темы, неполными данными;
- граничные случаи: отказ, агрессия, «не понял», обрыв связи, повторные попытки.
Каждый сценарий прогоняйте минимум в трёх акцентах и четырёх состояниях звука: чистый звук, шум, частые перебивания, быстрая или смазанная речь. Получается не меньше дюжины вариантов на сценарий. Критерий прохождения: задача выполнена, передача человеку сработала там, где нужно, и поведение при ошибке понятно клиенту.
Шаг 3. Выберите формат записей
- Живые голоса. Дают настоящие акценты, темп и запинки. Плохо масштабируются, зато подходят как эталонный набор для повторных проверок.
- Синтетические голоса. Позволяют быстро получить много вариантов с разным акцентом, темпом и шумом. Хуже передают живую интонацию и ошибки людей, для которых язык не родной.
- Сочетание. Мы советуем ориентироваться на 20–50 записей живых голосов, по 5–10 на каждую акцентную группу, и добавить синтетические вариации: разные шумы, каналы, перебивания, скорости.
4. Акценты
Откуда брать данные
Публичные наборы записей с разметкой по акцентам, шумам и качеству канала помогают сравнить системы распознавания речи на одинаковых акцентах и найти слабые группы.
Самый полезный источник — ваши собственные записи: реальные звонки с вашей терминологией и привычным фоном. Собирайте по каждой акцентной группе десятки разных голосов, а не по паре «любимых сотрудников», иначе систему подгонят под интонации конкретных людей.
Метрики
Распознавание речи (диагностика):
- доля ошибок в расшифровке (WER и CER) по акцентным группам показывает, где распознавание «сыпется» сильнее всего;
- точность извлечения данных: даты, суммы, имена, адреса.
Работа агента целиком:
- доля выполненных задач по акценту и сценарию;
- точность определения намерения клиента по акценту;
- доля успешных исправлений («нет, не так»): как часто исправление приводит к верным данным;
- корректность передачи человеку после серии неудачных попыток понять клиента.
Мы опираемся на метрики работы агента целиком, а расшифровку считаем вспомогательной. Клиента интересует результат его задачи, процент ошибок в расшифровке ему безразличен.
Практика
- Сравните системы на одном наборе. Один и тот же набор акцентов прогоните через разные конфигурации и сравнивайте выполнение задач, а не только долю ошибок в расшифровке. Система с худшим средним показателем на общем наборе может лучше вести себя на сложных акцентах вашей аудитории.
- Определяйте акцент. По акценту можно переключать акустическую модель, вариант языка или сценарий диалога.
- Упрощайте диалог для тяжёлых акцентов. Задавайте короткие однозначные вопросы, подтверждайте критичные данные (имя, номер, сумму, адрес) повтором или по буквам и быстрее передавайте человеку после нескольких непониманий подряд.